5편에서 클러스터 전체 상태를 수집했다면, 이번 편에서는 각 노드의 상세 리소스를 수집합니다. 클러스터 API가 노드 수와 온라인 여부만 알려준다면, 노드 API는 실제 리소스 사용량을 알려줍니다.
수집 대상 API 경로
| 수집 항목 | API 경로 |
|---|---|
| 노드 목록 (온라인 여부 포함) | /api2/json/cluster/resources?type=node |
| 노드 상세 리소스 | /api2/json/nodes/{node}/status |
| 네트워크 트래픽 | /api2/json/nodes/{node}/netstat |
노드 목록은 클러스터 API로 조회하고, 상세 리소스와 netstat은 해당 노드에 직접 요청해야 합니다. 4편에서 설명한 NODE_IPS 매핑이 여기서 사용됩니다.
노드 LLD 구현
노드가 추가되거나 이름이 바뀔 때마다 Zabbix 아이템을 수동으로 만드는 것은 번거롭습니다. LLD로 노드를 자동 발견하도록 구성합니다.
def do_node_discovery():
    data = api("/api2/json/cluster/resources?type=node")
    lld = [
        {"{#NODE}": n["node"], "{#IP}": NODE_IPS.get(n["node"], "")}
        for n in data
    ]
    subprocess.run(
        ["docker", "exec", "zabbix-server",
         "zabbix_sender", "-z", "127.0.0.1", "-p", "10051",
         "-s", ZABBIX_HOST,
         "-k", "proxmox.node.discovery",
         "-o", json.dumps(lld)],
        capture_output=True, timeout=30
    )
Discovery JSON 예시:
[
  {"{#NODE}": "pve11", "{#IP}": "10.0.92.11"},
  {"{#NODE}": "pve12", "{#IP}": "10.0.92.12"},
  {"{#NODE}": "pve13", "{#IP}": "10.0.92.13"}
]
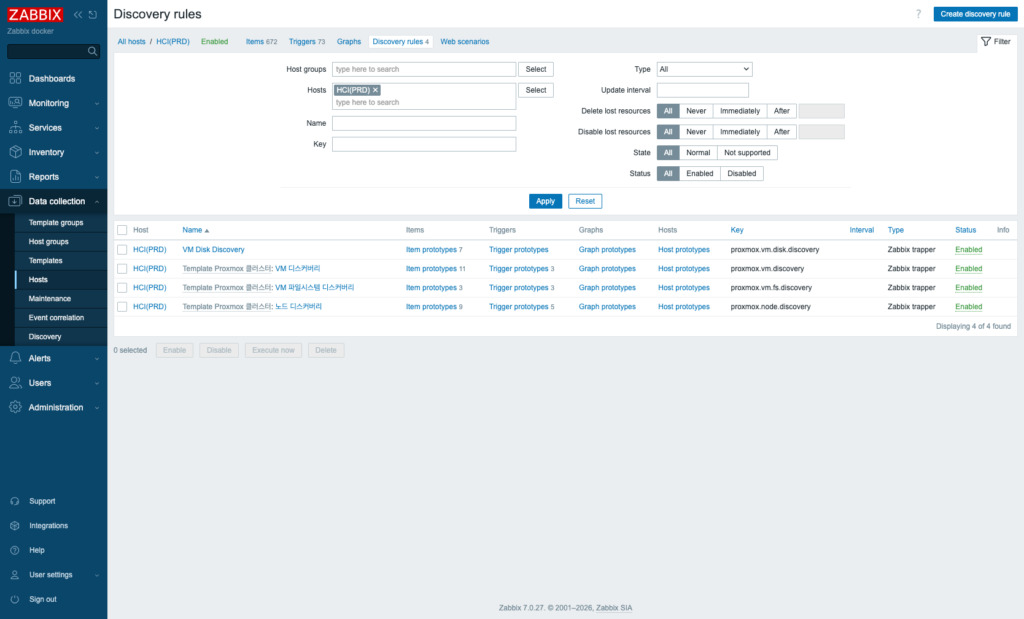
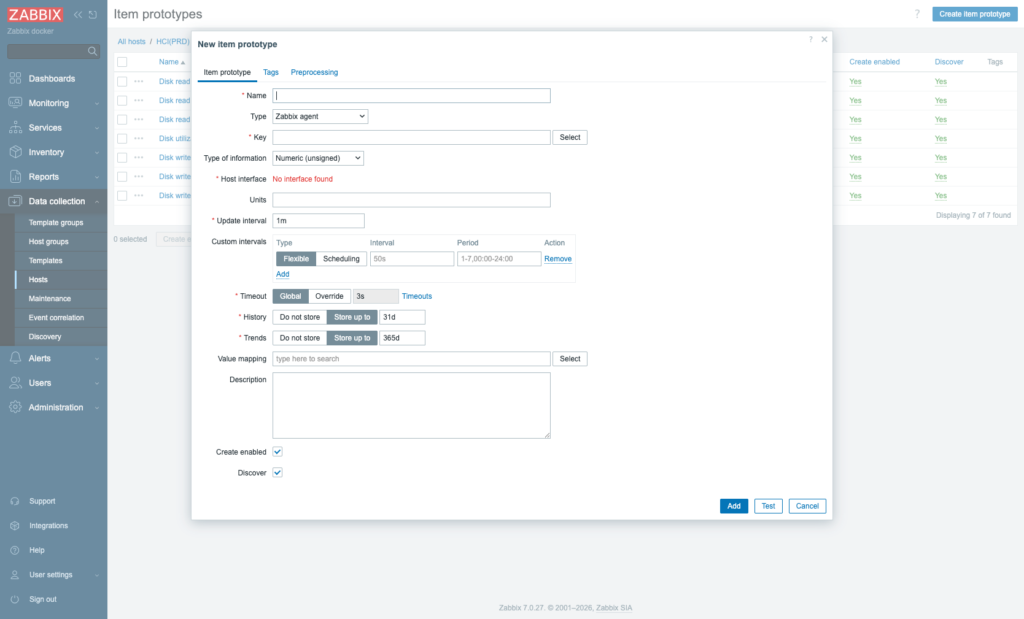
Zabbix의 Discovery Rule에 이 키(proxmox.node.discovery)를 등록하고, Item Prototype에 {#NODE} 매크로를 사용하면 노드별 아이템이 자동 생성됩니다.
노드 리소스 수집
노드 목록을 먼저 조회한 뒤, 온라인 노드에 한해서만 상세 API를 호출합니다:
def do_collect_nodes():
    lines = []
    nodes_data = api("/api2/json/cluster/resources?type=node")
    for n in nodes_data:
        node   = n["node"]
        online = 1 if n.get("status") == "online" else 0
        lines.append(sl(ZABBIX_HOST, f"proxmox.node.status[{node}]", online))
        lines.append(sl(ZABBIX_HOST, f"proxmox.node.hastate[{node}]",
                        1 if n.get("hastate") == "online" else 0))
        if not online:
            continue  # 오프라인 노드는 상세 수집 생략
        ip     = NODE_IPS.get(node)
        detail = api(f"/api2/json/nodes/{node}/status", node_ip=ip)
        if not detail:
            continue
        mem     = detail.get("memory", {})
        rootfs  = detail.get("rootfs", {})
        swap    = detail.get("swap", {})
        loadavg = detail.get("loadavg", ["0", "0", "0"])
        lines += [
            sl(ZABBIX_HOST, f"proxmox.node.cpu[{node}]",
               round(n.get("cpu", 0) * 100, 2)),
            sl(ZABBIX_HOST, f"proxmox.node.mem.used[{node}]",   mem.get("used", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.mem.total[{node}]",  mem.get("total", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.rootfs.used[{node}]",  rootfs.get("used", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.rootfs.total[{node}]", rootfs.get("total", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.uptime[{node}]",     detail.get("uptime", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.load1[{node}]",      loadavg[0]),
            sl(ZABBIX_HOST, f"proxmox.node.load5[{node}]",      loadavg[1]),
            sl(ZABBIX_HOST, f"proxmox.node.load15[{node}]",     loadavg[2]),
            sl(ZABBIX_HOST, f"proxmox.node.swap.used[{node}]",  swap.get("used", 0)),
            sl(ZABBIX_HOST, f"proxmox.node.swap.total[{node}]", swap.get("total", 0)),
        ]
CPU 값 변환: 클러스터 리소스 API의 cpu 값은 0.0~1.0 범위의 소수입니다. * 100으로 퍼센트로 변환합니다.
메모리/스토리지 단위: used, total 값은 바이트(byte) 단위입니다. Zabbix에 그대로 저장하고, 아이템의 Units를 B로 설정하면 웹 UI에서 자동으로 GB/MB로 변환해 표시합니다.
네트워크 트래픽 수집과 타입 오류
netstat API는 노드의 모든 인터페이스 트래픽을 반환합니다. 전체 합산 값을 수집합니다:
netstats = api(f"/api2/json/nodes/{node}/netstat", node_ip=ip)
if netstats:
    total_in = total_out = 0
    for iface in netstats:
        total_in  += int(iface.get("in", 0) or 0)
        total_out += int(iface.get("out", 0) or 0)
    lines += [
        sl(ZABBIX_HOST, f"proxmox.node.netin[{node}]",  total_in),
        sl(ZABBIX_HOST, f"proxmox.node.netout[{node}]", total_out),
    ]
여기서 중요한 함정이 있습니다.
Proxmox netstat API의 in과 out 값은 문자열(string)로 반환됩니다. 숫자처럼 보이지만 타입이 str입니다. 그냥 더하면 문자열 연결이 발생합니다:
# 잘못된 코드 — 문자열 연결 발생
total_in += iface.get("in", 0)  # "1234" + "5678" = "12345678"
# 올바른 코드
total_in += int(iface.get("in", 0) or 0)
or 0 처리가 추가된 이유는 값이 None이거나 빈 문자열일 경우 int() 변환 오류가 발생할 수 있어서입니다.
대용량 데이터 전송 방식
노드 수가 많아지면 zabbix_sender에 stdin으로 데이터를 전달하는 방식이 한계에 부딪힐 수 있습니다. Node Collector에서는 임시 파일을 경유하는 방식을 사용합니다:
def send(lines):
    if not lines:
        return
    tmp = "/tmp/zabbix_node_prod.txt"
    with open(tmp, "w") as f:
        f.write("\n".join(lines) + "\n")
    # 호스트의 파일을 컨테이너로 복사
    subprocess.run(
        ["docker", "cp", tmp, "zabbix-server:/tmp/zabbix_node_prod.txt"],
        capture_output=True, timeout=10
    )
    # 컨테이너 내부에서 파일로 전송
    proc = subprocess.run(
        ["docker", "exec", "zabbix-server",
         "zabbix_sender", "-z", "127.0.0.1", "-p", "10051",
         "-i", "/tmp/zabbix_node_prod.txt"],
        capture_output=True, text=True, timeout=30
    )
    sys.stderr.write(f"[INFO] sender: {proc.stdout.strip()}\n")
docker cp로 호스트의 파일을 컨테이너 내부로 복사한 뒤, zabbix_sender -i 옵션으로 파일을 직접 읽게 합니다. stdin 파이프보다 안정적으로 대량 데이터를 처리할 수 있습니다.
수집 아이템 목록
Item Prototype으로 등록할 키 목록입니다. {#NODE}는 LLD 매크로입니다:
| 키 | 설명 | 단위 |
|---|---|---|
| proxmox.node.status[{#NODE}] | 온라인 여부 (1/0) | – |
| proxmox.node.hastate[{#NODE}] | HA 상태 (1/0) | – |
| proxmox.node.cpu[{#NODE}] | CPU 사용률 | % |
| proxmox.node.mem.used[{#NODE}] | 메모리 사용량 | B |
| proxmox.node.mem.total[{#NODE}] | 메모리 전체 | B |
| proxmox.node.rootfs.used[{#NODE}] | 루트 디스크 사용량 | B |
| proxmox.node.rootfs.total[{#NODE}] | 루트 디스크 전체 | B |
| proxmox.node.uptime[{#NODE}] | 업타임 | s |
| proxmox.node.load1[{#NODE}] | Load Average 1분 | – |
| proxmox.node.load5[{#NODE}] | Load Average 5분 | – |
| proxmox.node.load15[{#NODE}] | Load Average 15분 | – |
| proxmox.node.swap.used[{#NODE}] | Swap 사용량 | B |
| proxmox.node.swap.total[{#NODE}] | Swap 전체 | B |
| proxmox.node.netin[{#NODE}] | 네트워크 수신 누적 | B |
| proxmox.node.netout[{#NODE}] | 네트워크 송신 누적 | B |
네트워크 수신/송신은 누적 카운터입니다. Zabbix 아이템 타입을 Delta (speed per second)로 설정하면 초당 트래픽(bps)으로 자동 변환됩니다.
트리거 설계
# 노드 오프라인 — High
last(/proxmox-cluster-prod/proxmox.node.status[{#NODE}]) = 0
# CPU 과부하 (최근 3회 평균 90% 초과) — Average
avg(/proxmox-cluster-prod/proxmox.node.cpu[{#NODE}],#3) > 90
# 메모리 사용률 95% 초과 — Average
last(/proxmox-cluster-prod/proxmox.node.mem.used[{#NODE}])
  / last(/proxmox-cluster-prod/proxmox.node.mem.total[{#NODE}]) * 100 > 95
# 루트 디스크 사용률 85% 초과 — Warning
last(/proxmox-cluster-prod/proxmox.node.rootfs.used[{#NODE}])
  / last(/proxmox-cluster-prod/proxmox.node.rootfs.total[{#NODE}]) * 100 > 85
crontab 등록
# Proxmox PRD Node Collector (2분)
*/2 * * * * /usr/bin/python3 /data/zabbix/scripts/proxmox_node_collector_prod.py --node-collect >> /var/log/zabbix-collector.log 2>&1
# Proxmox PRD Node Discovery (10분)
*/10 * * * * /usr/bin/python3 /data/zabbix/scripts/proxmox_node_collector_prod.py --node-discovery >> /var/log/zabbix-collector.log 2>&1
Discovery는 자주 실행할 필요가 없습니다. 노드 구성이 바뀌는 경우가 드물기 때문에 10분 주기로 충분합니다.
마치며
이번 편에서 다룬 핵심 포인트입니다:
- 노드 LLD로 동적 아이템 자동 생성
- 오프라인 노드 감지 시 상세 수집 생략으로 불필요한 오류 방지
- netstat
in/out값이 문자열 —int()변환 필수 - 대량 데이터는
docker cp+ 파일 방식으로 안정적 전송 - 네트워크 카운터는
Delta타입으로 초당 속도 변환
다음 편에서는 물리 디스크 SMART 데이터 수집을 다룹니다. SAS와 SATA/NVMe의 응답 형식이 달라 파싱 방법이 다르고, HBA 교체 후 stale value로 인한 오탐 사례도 구체적으로 설명합니다.