스토리지 서버는 조용히 문제가 쌓이다가 어느 날 갑자기 데이터 손실로 이어지는 경우가 많습니다. ZFS 기반의 TrueNAS는 풀 상태, Scrub, 알림 등 다양한 지표를 API로 제공합니다. 이번 편에서는 이를 Zabbix로 수집하는 전체 구조를 다룹니다.
TrueNAS REST API 인증
TrueNAS API v2.0은 Bearer 토큰 인증을 사용합니다. OPNsense의 Key/Secret과 달리 단일 토큰입니다.
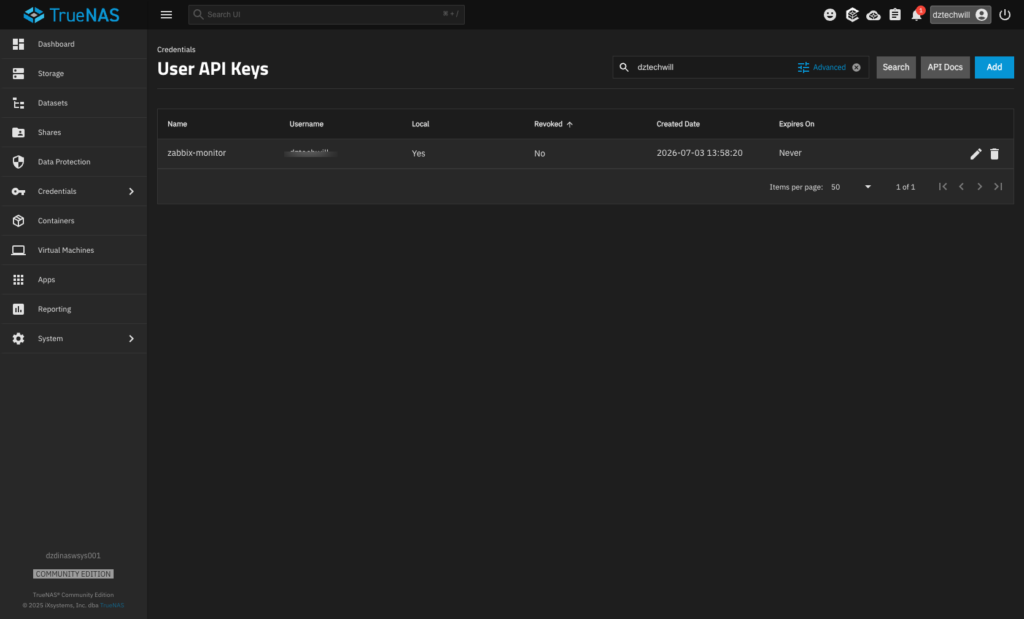
발급된 토큰을 Authorization 헤더에 포함합니다:
req = urllib.request.Request(
    url, method=method, data=data,
    headers={
        "Authorization": f"Bearer {cfg['api_key']}",
        "Content-Type": "application/json"
    }
)
API 기본 경로는 https://NAS_IP/api/v2.0입니다.
사이트 설정
PRD와 DEV TrueNAS를 동일한 스크립트로 관리합니다:
SITES = {
    "1": {
        "host":        "10.0.12.61",
        "api_key":     "발급된-토큰",
        "zabbix_host": "truenas-prd",
        "services":    ["nfs", "ssh"],
    },
    "2": {
        "host":        "10.0.31.61",
        "api_key":     "발급된-토큰",
        "zabbix_host": "truenas-dev",
        "services":    ["nfs", "ssh"],
    },
}
ZFS 풀 상태 및 용량
ZFS 풀은 스토리지 모니터링의 핵심입니다. /pool API가 풀의 전체 정보를 반환합니다:
POOL_STATUS_MAP = {
    "ONLINE":   0,
    "DEGRADED": 1,
    "FAULTED":  2,
    "OFFLINE":  3,
    "REMOVED":  4,
    "UNAVAIL":  5,
}
pools = api_call(cfg, "/pool")
for p in pools:
    name   = p["name"]
    status = p.get("status", "UNKNOWN")
    size   = p.get("size") or 0
    free   = p.get("free") or 0
    used   = size - free
    pct    = round(used / size * 100, 2) if size else 0
    lines += [
        sl(zh, f"truenas.pool.status[{name}]", POOL_STATUS_MAP.get(status, 9)),
        sl(zh, f"truenas.pool.size[{name}]",   size),
        sl(zh, f"truenas.pool.used[{name}]",   used),
        sl(zh, f"truenas.pool.free[{name}]",   free),
        sl(zh, f"truenas.pool.pct[{name}]",    pct),
    ]
풀 상태 의미:
| 상태 | 값 | 의미 |
|---|---|---|
| ONLINE | 0 | 정상 |
| DEGRADED | 1 | 디스크 일부 장애 — 데이터 보호 수준 저하 |
| FAULTED | 2 | 풀 심각 오류 — 즉각 조치 필요 |
| OFFLINE | 3 | 풀 오프라인 |
| UNAVAIL | 5 | 데이터 접근 불가 |
DEGRADED는 RAID 구성에서 디스크 하나가 빠진 상태입니다. 데이터는 읽히지만 또 다른 디스크가 고장나면 데이터 손실이 발생합니다. DEGRADED 알림은 Disaster 수준으로 처리해야 합니다.
vdev 디스크 상태 감지
풀 상태가 DEGRADED가 되기 전에 개별 디스크 상태를 먼저 감지합니다:
vdevs = p.get("topology", {}).get("data", [])
disk_faulted = 0
for vdev in vdevs:
    for child in vdev.get("children", []):
        if child.get("status") not in ("ONLINE", None):
            disk_faulted += 1
lines.append(sl(zh, f"truenas.pool.disk_faulted[{name}]", disk_faulted))disk_faulted가 0보다 크면 특정 디스크에 문제가 생긴 것입니다. 풀 상태가 바뀌기 전에 미리 감지할 수 있습니다.
데이터셋 사용량
풀 하위의 각 데이터셋 용량을 수집합니다:
datasets = api_call(cfg, f"/pool/dataset?pool={p['name']}")
for d in datasets:
    dname = d["name"]
    if "/" not in dname:
        continue  # 루트 풀 데이터셋 제외
    props = d.get("properties", {})
    used_bytes  = int(props.get("used",      {}).get("rawvalue", 0) or 0)
    avail_bytes = int(props.get("available", {}).get("rawvalue", 0) or 0)
    if used_bytes > 0 or avail_bytes > 0:
        lines += [
            sl(zh, f"truenas.dataset.used[{dname}]",  used_bytes),
            sl(zh, f"truenas.dataset.avail[{dname}]", avail_bytes),
]rawvalue는 바이트 단위 정수값입니다. value는 사람이 읽기 좋은 형태("1.23 TiB")이므로 계산에는 rawvalue를 사용합니다.
ZFS Scrub 상태
Scrub은 ZFS 풀의 데이터 무결성을 검사하는 작업입니다. 정기적으로 실행해야 하며, 마지막 실행 이후 경과 일수와 오류 수를 수집합니다:
scan   = p.get("scan") or {}
state  = scan.get("state") or "NONE"
errors = scan.get("errors") or 0
end_time = scan.get("end_time")
if end_time and isinstance(end_time, dict):
    ts = end_time.get("$date", 0) / 1000  # 밀리초 → 초
    days_ago = round((time.time() - ts) / 86400, 1)
elif isinstance(end_time, (int, float)) and end_time > 0:
    days_ago = round((time.time() - end_time) / 86400, 1)
else:
    days_ago = -1  # 한 번도 실행 안 함
state_val = 0 if state == "FINISHED" else (1 if state == "SCANNING" else 2)
lines += [
    sl(zh, f"truenas.scrub.state[{name}]",    state_val),
    sl(zh, f"truenas.scrub.errors[{name}]",   errors),
    sl(zh, f"truenas.scrub.days_ago[{name}]", days_ago),
]
end_time 필드의 형식이 TrueNAS 버전에 따라 다릅니다. {"$date": 밀리초} 형태이거나 Unix timestamp 정수인 경우 모두 처리합니다.
트리거 예시:
# Scrub 오류 발생 — High
last(/truenas-prd/truenas.scrub.errors[tank]) > 0
# 마지막 Scrub 30일 초과 — Warning
last(/truenas-prd/truenas.scrub.days_ago[tank]) > 30
활성 알림 수집
TrueNAS 자체 알림 시스템의 발생 건수를 수집합니다:
ALERT_LEVEL_MAP = {
    "INFO": 0, "NOTICE": 1, "WARNING": 2,
    "ERROR": 3, "CRITICAL": 4, "ALERT": 5, "EMERGENCY": 6
}
alerts = api_call(cfg, "/alert/list")
if alerts is not None:
    alert_count    = len(alerts)
    alert_warning  = sum(1 for a in alerts
                         if ALERT_LEVEL_MAP.get(a.get("level", "INFO"), 0) >= 2)
    alert_critical = sum(1 for a in alerts
                         if ALERT_LEVEL_MAP.get(a.get("level", "INFO"), 0) >= 4)
    lines += [
        sl(zh, "truenas.alert.total",    alert_count),
        sl(zh, "truenas.alert.warning",  alert_warning),
        sl(zh, "truenas.alert.critical", alert_critical),
    ]
TrueNAS 알림은 디스크 온도, S.M.A.R.T. 경고, 풀 상태 변화 등 다양한 이벤트를 포함합니다. alert_critical이 0보다 크면 즉시 확인이 필요합니다.
ZFS ARC 크기와 CPU 온도
# ARC 크기 (ZFS 캐시 메모리 사용량)
arc_data = api_call(cfg, "/reporting/get_data", "POST",
                    json_data={"graphs": [{"name": "arcsize", "identifier": None}]})
if arc_data and arc_data[0].get("data"):
    arc_size = arc_data[0]["data"][-1][1]
    if arc_size:
        lines.append(sl(zh, "truenas.arc.size", int(arc_size)))
# CPU 온도 (코어 중 최댓값)
cputemp = api_call(cfg, "/reporting/get_data", "POST",
                   json_data={"graphs": [{"name": "cputemp", "identifier": None}]})
if cputemp and cputemp[0].get("data"):
    last = cputemp[0]["data"][-1]
    temps = [v for v in last[1:] if isinstance(v, (int, float)) and v > 0]
    if temps:
        lines.append(sl(zh, "truenas.cpu.temp_max", round(max(temps), 1)))
ARC는 ZFS의 읽기 캐시입니다. 크기가 클수록 디스크 I/O를 줄여 성능이 향상됩니다. 갑작스러운 감소는 메모리 압박 상황을 의미합니다.
LLD: 풀·데이터셋 자동 발견
def do_discovery(cfg):
    zh = cfg["zabbix_host"]
    # 풀 Discovery
    pools = api_call(cfg, "/pool")
    pool_lld = [{"{#POOLNAME}": p["name"]} for p in pools] if pools else []
    push_single(zh, "truenas.pool.discovery", json.dumps(pool_lld))
    # 데이터셋 Discovery
    dataset_lld = []
    if pools:
        for p in pools:
            datasets = api_call(cfg, f"/pool/dataset?pool={p['name']}")
            if datasets:
                for d in datasets:
                    if "/" in d["name"]:
                        dataset_lld.append({
                            "{#DATASET}": d["name"],
                            "{#POOL}":    p["name"],
                        })
    push_single(zh, "truenas.dataset.discovery", json.dumps(dataset_lld))
풀과 데이터셋이 추가되면 LLD가 자동으로 새 아이템을 생성합니다. 루트 풀 데이터셋(이름에 /가 없는 항목)은 제외합니다.
수집 항목 전체 목록
| 키 | 설명 |
|---|---|
| truenas.system.uptime | 시스템 업타임 (초) |
| truenas.pool.status[{#POOLNAME}] | ZFS 풀 상태 (0=ONLINE) |
| truenas.pool.pct[{#POOLNAME}] | 풀 사용률 (%) |
| truenas.pool.disk_faulted[{#POOLNAME}] | 장애 디스크 수 |
| truenas.dataset.used[{#DATASET}] | 데이터셋 사용량 (B) |
| truenas.dataset.avail[{#DATASET}] | 데이터셋 여유 공간 (B) |
| truenas.service[nfs] | NFS 서비스 상태 |
| truenas.alert.critical | Critical 이상 알림 수 |
| truenas.scrub.errors[{#POOLNAME}] | Scrub 오류 수 |
| truenas.scrub.days_ago[{#POOLNAME}] | 마지막 Scrub 경과 일수 |
| truenas.arc.size | ZFS ARC 크기 (B) |
| truenas.cpu.temp_max | CPU 최고 온도 (°C) |
| truenas.nfs.clients | NFS 연결 클라이언트 수 |
crontab 등록
# TrueNAS PRD 수집 (3분)
*/3 * * * * /usr/bin/python3 /data/zabbix/scripts/truenas_collector.py --collect --site 1 >> /var/log/zabbix-collector.log 2>&1
# TrueNAS DEV 수집 (3분)
*/3 * * * * /usr/bin/python3 /data/zabbix/scripts/truenas_collector.py --collect --site 2 >> /var/log/zabbix-collector.log 2>&1
# TrueNAS Discovery (10분)
*/10 * * * * /usr/bin/python3 /data/zabbix/scripts/truenas_collector.py --discovery --site 1 >> /var/log/zabbix-collector.log 2>&1
*/10 * * * * /usr/bin/python3 /data/zabbix/scripts/truenas_collector.py --discovery --site 2 >> /var/log/zabbix-collector.log 2>&1
데이터셋 사용량 API 호출이 풀당 한 번씩 발생하므로 풀이 많으면 수집 시간이 늘어납니다. API 타임아웃을 넉넉하게(20초) 설정하는 것이 좋습니다.
마치며
이번 편에서 다룬 핵심 포인트입니다:
- TrueNAS API는 Bearer 토큰 인증 — 단일 토큰 발급
- DEGRADED 상태는 즉각 대응 필요 — Disaster 수준 트리거 권장
rawvalue로 용량 계산,value는 표시용end_time형식이 TrueNAS 버전별로 다름 — 두 가지 형식 모두 처리- Scrub 미실행 30일 초과 트리거로 정기 점검 보장
- LLD로 풀·데이터셋 추가 시 자동 아이템 생성
다음 편에서는 지금까지 만든 모든 수집 스크립트의 cron 스케줄을 어떻게 설계했는지, 부하를 최소화하면서 최적의 수집 주기를 찾는 방법을 다룹니다.